
Prefácio
Este material é baseado no livro desenvolvido pela OpenIntro, OpenIntro Statistics, que fornece uma introdução à estatística, a nível de graduação. O material original está disponível no github em formato TeX. Tanto este material adaptado, quanto o original, estão sob mesma licença no Creative Commons.
Juliana Sena de Souza
Márcia Helena Barbian
Lisiane Priscila Roldão Selau
Markus Chagas Stein
Rodrigo Citton Padilha dos Reis

This work is licensed under a Creative Commons Attribution-ShareAlike 3.0 Unported License.

1 Introdução à Regressão Linear
A regressão linear é uma técnica estatística muito poderosa. Muitas pessoas têm alguma familiaridade com regressão apenas lendo as notícias, onde gráficos com linhas retas são sobrepostos em gráficos de dispersão. Modelos lineares podem ser usados para previsão ou para avaliar se existe uma relação linear entre duas variáveis numéricas.
A Figura 1.1 mostra duas variáveis cuja relação pode ser modelada perfeitamente com uma linha reta. A equação da linha é
\[\begin{eqnarray*} y = 5 + 57.49x \end{eqnarray*}\]
Imagine o que um relacionamento linear perfeito significaria: você saberia o valor exato de \(y\) apenas conhecendo o valor de \(x\). Isso não é realista em quase todos os processos naturais. Por exemplo, se tomarmos a renda familiar \(x\), esse valor fornecerá algumas informações úteis sobre quanto apoio financeiro \(y\) que a faculdade pode oferecer a um aluno em potencial. No entanto, ainda haveria variabilidade no apoio financeiro, mesmo quando se comparasse alunos cujas famílias tivessem históricos financeiros semelhantes.
set.seed(4)
x <- sample(33, 12, prob = c(33:24, 11:33))
y <- 5 + 57.49 * x


ggplot() +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  labs(x = 'Número de ações da Target Corporation para comprar',
       y = 'Custo total das ações (dólares)') +
  geom_smooth(aes(x, y), color = 'black', se = FALSE,
              method = 'lm', formula = y ~ x, linetype = 'dashed') +
geom_point(aes(x, y), color = 'skyblue3', size = 2) 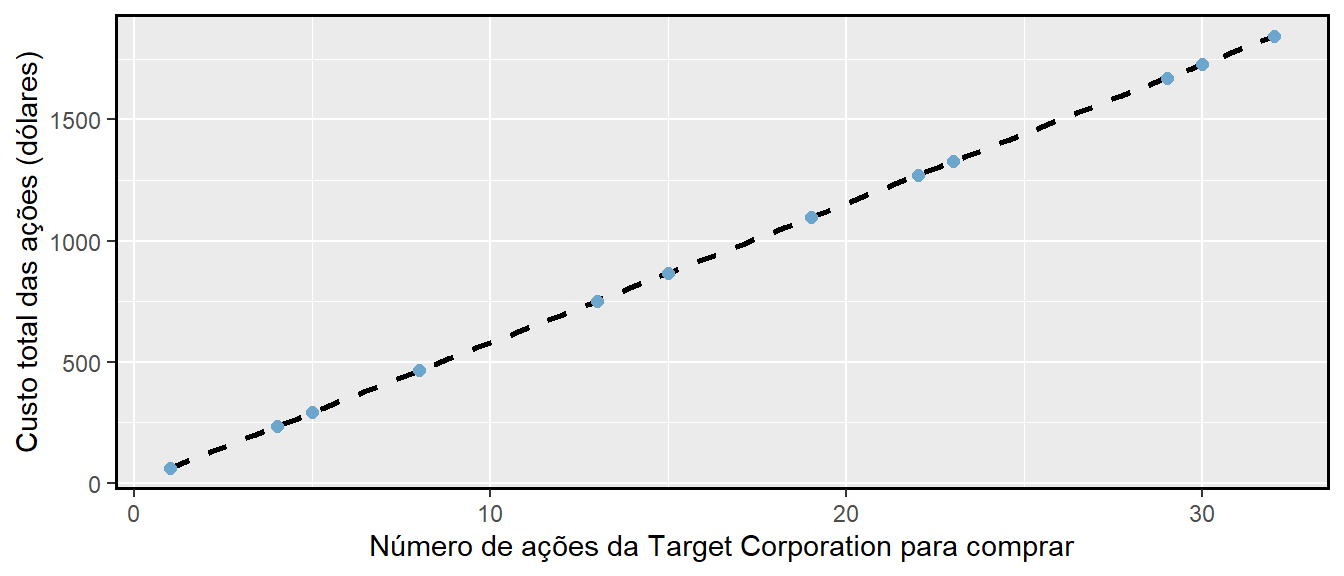
Figura 1.1: Solicitações de doze compradores separados foram colocadas simultaneamente com uma empresa comercial para comprar ações da Target Corporation (ticker TGT, April 26th, 2012), e o custo total das ações foram relatados. Porque o custo é calculado usando uma fórmula linear, o ajuste linear é perfeito.
A regressão linear assume que o relacionamento entre duas variáveis, \(x\) e \(y\), pode ser modelado por uma linha reta:
\[\begin{eqnarray} y = \beta_0 + \beta_1x \tag{1.1} \end{eqnarray}\] onde \(\beta_0\) e \(\beta_1\) representam dois parâmetros do modelo (\(\beta\) é a letra grega beta). Esses parâmetros são estimados usando dados e escrevemos suas estimativas pontuais como \(b_0\) e \(b_1\). Quando usamos \(x\) para prever \(y\), geralmente chamamos \(x\) da variável explicativa ou preditora, e chamamos \(y\) de resposta.
É raro que todos os dados caiam em linha reta, como visto nos três diagramas de dispersão na Figura 1.2. Em cada caso, os dados caem em uma linha reta, mesmo que nenhuma das observações caia exatamente na linha. O primeiro gráfico mostra uma tendência linear descendente relativamente forte, em que a variabilidade restante nos dados ao redor da linha é menor em relação à força do relacionamento entre \(x\) e \(y\). O segundo gráfico mostra uma tendência ascendente que, embora evidente, não é tão forte quanto a primeira. O último gráfico mostra uma tendência de queda muito fraca nos dados, tão pequena que mal podemos notar. Em cada um desses exemplos, teremos alguma incerteza em relação às nossas estimativas dos parâmetros do modelo, \(\beta_0\) e \(\beta_1\). Por exemplo, podemos nos perguntar, devemos mover a linha para cima ou para baixo um pouco, ou devemos incliná-la mais ou menos? À medida que avançamos neste capítulo, aprenderemos diferentes critérios de ajuste linear e também aprenderemos sobre a incerteza associada às estimativas dos parâmetros do modelo.
library(openintro)
data(COL)

n <- c(75, 49, 376)

set.seed(3)


x1 <- rnorm(n[1], 16, 33)
y1 <- 14 - 0.8 * x1 + rnorm(n[1], sd = 12)

x2 <- rnorm(n[2], 1052, 300)
y2 <- 1400 + 7 * x2 + rnorm(n[2], sd = 4020)

x3 <- c(rnorm(100, 20, 8), runif(n[3] - 100, -10, 52))
y3 <- 140 - 0.15 * x3 + rnorm(n[3], sd = 102)

g1 <- ggplot(mapping = aes(x1, y1)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  labs(x = NULL, y = NULL) +
  geom_smooth(formula = y ~ x, se = FALSE, method = 'lm', color = 'black')

g2 <- ggplot(mapping = aes(x2, y2)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  labs(x = NULL, y = NULL) +
  geom_smooth(formula = y ~ x, se = FALSE, method = 'lm', color = 'black')

g3 <- ggplot(mapping = aes(x3, y3)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  labs(x = NULL, y = NULL) +
  geom_smooth(formula = y ~ x, se = FALSE, method = 'lm', color = 'black')

gridExtra::grid.arrange(g1, g2, g3, ncol = 3)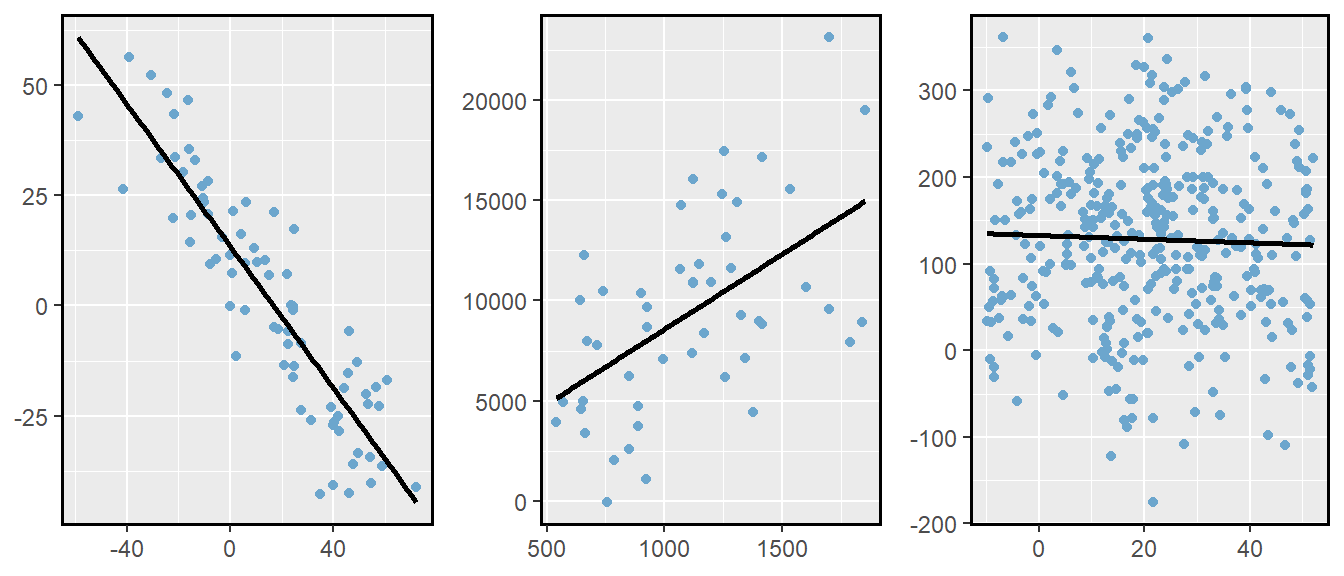
Figura 1.2: Três conjuntos de dados em que um modelo linear pode ser útil, mesmo que os dados não caiam exatamente na linha.
Também veremos exemplos neste capítulo em que encaixar uma linha reta nos dados, mesmo que haja uma relação clara entre as variáveis, não é útil. Um desses casos é mostrado na Figura 1.3 onde há uma relação muito forte entre as variáveis, embora a tendência não seja linear. Vamos discutir tendências não-lineares neste capítulo e no próximo, mas os detalhes da montagem de modelos não lineares são salvos para um curso posterior.
library(openintro)
data(COL)

set.seed(3)
theta <- seq(0, pi / 2, length.out = 25)
v <- 12
noise <- rnorm(length(theta), sd = 0)
x <- 2 * v^2 * sin(theta) * cos(theta) / 9.8 + noise

ggplot(mapping = aes(theta / pi * 2 * 90, x)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  labs(x = 'Ângulo de inclinação (graus)', y = 'Distância viajada (m)') +
  geom_smooth(formula = y ~ x, se = FALSE, method = 'lm', color = 'black') +
  annotate(geom = "text", x = 45, y = 7.5,
           label = 'A melhor reta para os dados é plana (!)', color = 'red', size = 3)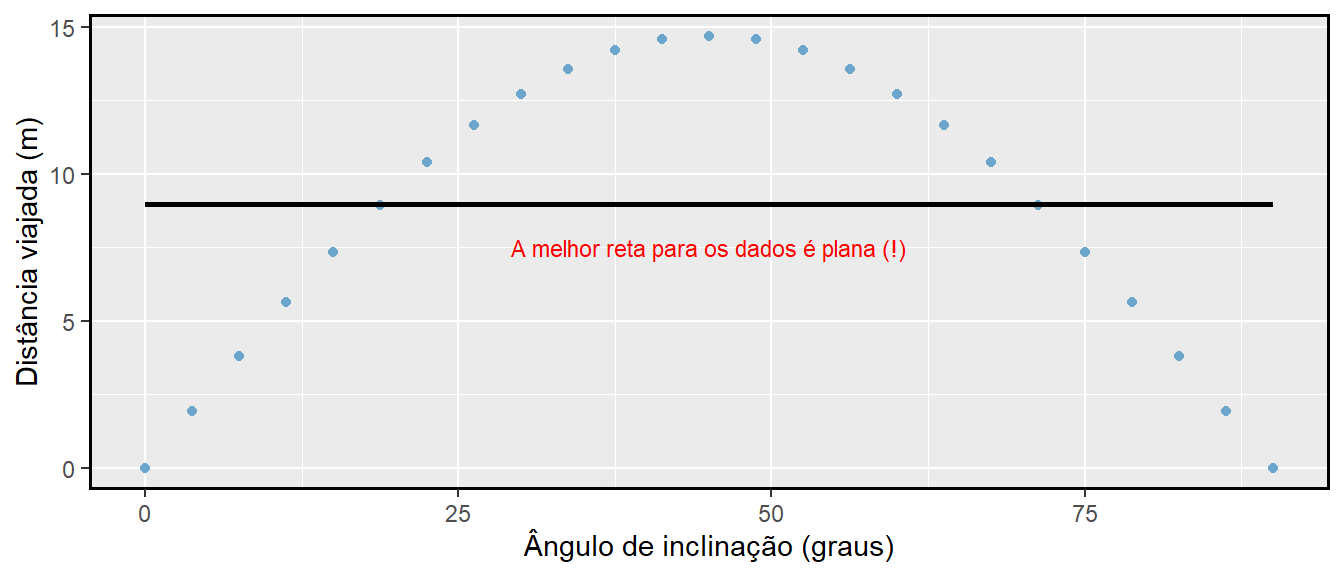
Figura 1.3: Um modelo linear não é útil neste caso não linear. Esses dados são de um experimento de física introdutória.
1.1 Ajuste linear, resíduos e correlação
É útil pensar profundamente sobre o processo de ajuste linear. Nesta seção, examinamos os critérios para identificar um modelo linear e introduzir uma nova estatística, a correlação.
1.1.1 Começando com linhas retas
Os diagramas de dispersão foram introduzidos no começo como técnica gráfica para apresentar duas variáveis numéricas simultaneamente. Tais gráficos permitem que a relação entre as variáveis seja examinada com facilidade. A Figura 1.4 mostra um gráfico de dispersão para o comprimento da cabeça e comprimento total de 104 gambás brushtail da Austrália. Cada ponto representa um único gambá.
library(openintro)
data(possum)

ggplot(data = possum) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(aes(totalL, headL), color = 'skyblue3') +
  labs(x = 'Comprimento Total (cm)', y = 'Comprimento da Cabeça (cm)') +
  geom_point(aes(89, 94.1), color = 'red') +
  geom_segment(aes(x = 89, y = min(headL), xend = 89, yend = 94.1),
               linetype = 'dashed', color = 'red') +
  geom_segment(aes(x = min(totalL), y = 94.1, xend = 89, yend = 94.1),
               linetype = 'dashed', color = 'red')
Figura 1.4: Um gráfico de dispersão mostrando o comprimento da cabeça em relação ao comprimento total para 104 gambás brushtail. Um ponto representando um gambá com comprimento de cabeça de 94,1 mm e comprimento total de 89 cm é destacado.
knitr::include_graphics('brushtail_possum.jpg')
(#fig:brushtail_possum)O gambá brushtail comum da Austrália. Foto: Greg Schechter
As variáveis comprimento de cabeça e total estão associadas. Os gambás com um comprimento total acima da média também tendem a ter comprimentos de cabeça acima da média. Embora o relacionamento não seja perfeitamente linear, pode ser útil explicar parcialmente a conexão entre essas variáveis com uma linha reta.
library(openintro)

data(possum)
data(cars)

gr1 <- ggplot(data = possum, mapping = aes(totalL, headL)) +
  geom_point(color = 'skyblue3') +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  labs(x = 'Comprimento Total (cm)', y = 'Comprimento da Cabeça (mm)') +
  geom_smooth(formula = y ~ x, method = 'lm', color = 'black')

gr2 <- ggplot(data = cars, mapping = aes(weight, mpgCity)) +
  geom_point(color = 'skyblue3') +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  labs(x = 'Peso (libras)', y = 'Milhas por galão (condução na cidade)') +
  geom_smooth(formula = y ~ x, method = 'auto', color = 'black')

gridExtra::grid.arrange(gr1, gr2, ncol = 2)
Figura 1.5: A figura à esquerda mostra o comprimento da cabeça versus comprimento total e revela que muitos dos pontos podem ser capturados por uma faixa reta. À direita, vemos que uma faixa curva é mais apropriada no gráfico de dispersão para peso e milhas por galão do conjunto de dados carros.
Linhas retas só devem ser usadas quando os dados parecem ter um relacionamento linear, como o caso mostrado no gráfico esquerdo da Figura 1.5. O gráfico direito da Figura 1.5 mostra um caso em que uma linha curva seria mais útil para entender a relação entre as duas variáveis.
Cuidado com tendências curvas: Consideramos apenas modelos baseados em linhas retas neste capítulo. Se os dados mostram uma tendência não linear, como no gráfico direito da Figura 1.5, técnicas mais avançadas devem ser usadas.
1.1.2 Sobrepor uma linha visualmente
Queremos descrever a relação entre as variáveis comprimento da cabeça e comprimento total no conjunto de dados do gambá usando uma linha. Neste exemplo, usaremos o comprimento total como variável preditora, \(x\), para prever o comprimento da cabeça de um gambá, \(y\). Poderíamos ajustar a relação linear a olho, como na Figura 1.6. A equação para esta linha é
\[\begin{eqnarray} \hat{y} = 41 + 0.59x \tag{1.2} \end{eqnarray}\]
Podemos usar essa linha para discutir propriedades de gambás. Por exemplo, a equação prevê que um gambá com um comprimento total de 80 cm terá um comprimento de cabeça
\[\begin{align*} \hat{y} &= 41 + 0,59\times 80 \\ &= 88,2 % mm \end{align*}\]
Um “chapéu” em \(y\) é usado para significar que isso é uma estimativa. Esta estimativa pode ser vista como uma média: a equação prevê que gambás com um comprimento total de 80cm terão um comprimento médio da cabeça de 88,2mm. Ausente mais informações sobre um gambá de 80cm, a previsão para o comprimento da cabeça que usa a média é uma estimativa razoável.
require(openintro)
data(possum)

these <- c(48, 42, 3)

temp1 = matrix(NA, nrow = 3, ncol = 2)
temp2 = matrix(NA, nrow = 3, ncol = 2)

for(i in 1:3){
  y2 <- 41 + 0.59 * possum$totalL[these[i]]

  temp1[i,] <- rep(possum$totalL[these[i]], 2)
  temp2[i,] <- c(possum$headL[these[i]], y2)
}

ggplot() +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(data = possum, aes(totalL, headL), color = 'skyblue3') +
  labs(x = 'Comprimento Total (cm)', y = 'Comprimento da Cabeça (cm)') +
  geom_abline(intercept = 41, slope = 0.59) +
  geom_point(aes(possum$totalL[these] + rnorm(3,0,0.02),
                 possum$headL[these] + rnorm(3,0,0.02)), shape = c(3, 4, 2), size = 3, color = 'red') +
  geom_segment(aes(x = temp1[,1], y = temp2[,1], xend = temp1[,2], yend = temp2[,2]),
               linetype = 'dashed', color = 'red')
Figura 1.6: Um modelo linear razoável foi ajustado para representar a relação entre comprimento da cabeça e comprimento total.
1.1.3 Resíduos
Resíduos são as variações restantes nos dados após a contabilização do ajuste do modelo:
\[\begin{align*} \text{Dados} = \text{Ajuste} + \text{Resíduos} \end{align*}\]
Cada observação terá um resíduo. Se uma observação estiver acima da linha de regressão, então seu resíduo, a distância vertical da observação até a linha, é positivo. Observações abaixo da linha têm resíduos negativos. Um objetivo ao escolher o modelo linear correto é que esses resíduos sejam tão pequenos quanto possível.
Três observações são anotadas especialmente na Figura 1.6. A observação marcada por um \(\times\) tem um pequeno resíduo negativo de cerca de -1; a observação marcada por \(+\) tem um grande resíduo de cerca de +7; e a observação marcada por \(\triangle\) tem um resíduo moderado de cerca de -4. O tamanho de um resíduo é geralmente discutido em termos de seu valor absoluto. Por exemplo, o resíduo de \(\triangle\) é maior que o de \(\times\) porque \(|-4|\) é maior que \(|-1|\).
Resíduos: diferença entre observado e esperado: O resíduo da i observação \((x_i, y_i)\) é a diferença da resposta observada (\(y_i\)) e a resposta que preveríamos com base no ajuste do modelo (\(\hat{y} _i\)):
\[\begin{eqnarray*} e_i = y_i - \hat{y}_i \end{eqnarray*}\]
Nós tipicamente identificamos \(\hat{y}_i\) conectando \(x_i\) no modelo.}
Primeiro calculamos o valor previsto do ponto \(\times\) baseado no modelo:
\[\begin{eqnarray*} \hat{y}_{\times} = 41+0,59x_{\times} = 41+0,59\times 77,0 = 86,4 \end{eqnarray*}\]
Em seguida, calculamos a diferença entre o comprimento real da cabeça e o comprimento da cabeça previsto:
\[\begin{eqnarray*} e_{\times} = y_{\times} - \hat{y}_{\times} = 85,3 - 86,4 = -1,1 \end{eqnarray*}\]
Isso é muito próximo da estimativa visual de -1.
Resíduos são úteis para avaliar quão bem um modelo linear se ajusta a um conjunto de dados. Costumamos exibi-los em um gráfico de resíduos como o mostrado na Figura 1.7 para a linha de regressão da Figura 1.6. Os resíduos são plotados em seus locais horizontais originais, mas com a coordenada vertical como resíduo. Por exemplo, o ponto \((85,0,98,6)_{+}\) tinha um resíduo de 7,45, então no gráfico de resíduos ele é colocado em \((85,0, 7,45)\). Criar um gráfico de resíduos é como derrubar o gráfico de dispersão para que a linha de regressão seja horizontal.
library(openintro)
data(possum)

these <- c(48, 42, 3)
y.extra <- 0.59 * possum$totalL[these] + rnorm(1,0,0.01)

g <- lm(headL ~ totalL, possum)

ggplot() +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(aes(possum$totalL, g$residuals), color = 'skyblue3') +
  labs(x = 'Comprimento Total (cm)', y = 'Residuals') +
  geom_hline(yintercept = 0, linetype = 'dashed') +
  geom_point(aes(possum$totalL[these] + rnorm(1, 0, 0.01),
                 possum$headL[these] - (41 + y.extra)), shape = c(3, 4, 2), size = 3, color = 'red')
Figura 1.7: Gráfico resíduo para o modelo do comprimento total x comprimento da cabeça
set.seed(1)

n1 <- 25
x1 <- runif(n1[1])
y1 <- -8 * x1 + rnorm(n1[1])

n2 <- 30
x2 <- c(runif(n2[1] - 2, 0, 4), 2, 2.1)
y2 <- -2 * x2^2 + rnorm(n2[1])

n3 <- 40
x3 <- runif(n3[1])
y3 <- 0.2 * x3 + rnorm(n3[1])
y3[y3 < -2] <- -1.5


p1 <- ggplot(mapping = aes(x1,y1)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank())

p2 <- ggplot(mapping = aes(x2,y2)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank())

p3 <- ggplot(mapping = aes(x3,y3)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank())

g1 <- lm(y1 ~ x1)
g2 <- lm(y2 ~ x2)
g3 <- lm(y3 ~ x3)

p4 <- ggplot(mapping = aes(x1,g1$residuals)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  geom_hline(yintercept = 0, linetype = 'dashed') +
  theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank())

p5 <- ggplot(mapping = aes(x2,g2$residuals)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  geom_hline(yintercept = 0, linetype = 'dashed') +
  theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank())

p6 <- ggplot(mapping = aes(x3,g3$residuals)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  geom_hline(yintercept = 0, linetype = 'dashed') +
  theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank())

require(gridExtra)
grid.arrange(p1, p2, p3, p4, p5, p6, ncol = 3)
Figura 1.8: Dados amostrais com suas melhores linhas de ajuste (linha superior) e seus gráficos de resíduos correspondentes (linha inferior).
No primeiro conjunto de dados (primeira coluna), os resíduos não mostram padrões óbvios. Os resíduos parecem estar espalhados aleatoriamente ao redor da linha tracejada que representa o 0.
O segundo conjunto de dados mostra um padrão nos resíduos. Há alguma curvatura no gráfico de dispersão, que é mais óbvia no gráfico de resíduos. Não devemos usar uma linha reta para modelar esses dados. Em vez disso, uma técnica mais avançada deve ser usada.
O último gráfico mostra muito pouca tendência ascendente e os resíduos também não mostram padrões óbvios. É razoável tentar ajustar um modelo linear aos dados. No entanto, não está claro se há evidências estatisticamente significativas de que o parâmetro de inclinação é diferente de zero. A estimativa pontual do parâmetro de inclinação, rotulado \(b_1\), não é zero, mas podemos nos perguntar se isso pode ser devido ao acaso. Vamos abordar esse tipo de cenário na Seção 1.4.
1.1.4 Descrevendo relacionamentos lineares com correlação
Correlação: força de um relacionamento linear: A correlação, que sempre recebe valores entre -1 e 1, descreve a força do relacionamento linear entre duas variáveis. Denotamos a correlação por \(R\).
Podemos calcular a correlação usando uma fórmula, assim como fizemos com a média e o desvio padrão da amostra. No entanto, esta fórmula é bastante complexa,3 então geralmente executamos os cálculos em um computador ou calculadora.
A Figura 1.9 mostra oito gráficos e suas correlações correspondentes. Somente quando o relacionamento é perfeitamente linear a correlação é -1 ou 1. Se o relacionamento for forte e positivo, a correlação será próxima de +1. Se for forte e negativo, será próximo de -1. Se não houver relação linear aparente entre as variáveis, a correlação será próxima de zero.
library(openintro)
data(possum)

plots_  <- function(x,y){

  ggplot() +
    geom_point(aes(x, y), color = 'skyblue3') +
    theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
    theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank()) +
    annotate(geom = "text", x = mean(x), y = min(y),
             label = paste0('R = ', round(cor(x,y),2)), color = 'black')

}

set.seed(1)

n <- 50
# _____ Line 1 _____ #
x <- c(runif(n[1] - 2, 0, 4), 2, 2.1)
y <- 0.8 * x + rnorm(n[1], sd = 5)

x2 <- c(runif(n[1] - 2, 0, 4), 2, 2.1)
y2 <- 2 * x2 + rnorm(n[1], sd = 0.5)


x3 <- runif(n[1])
y3 <- x3
y3[y3 < -2] <- -1.5

# _____ Line 2 _____ #

x4 <- c(runif(n[1]-2, 0, 4), 2, 2.1)
y4 <- -0.5 * x4 + rnorm(n[1], sd = 5)

x5 <- runif(n[1], -4.8, 4.8)
y5 <- -x5 + rnorm(n[1], sd = 3)

x6 <- runif(n[1])
y6 <- -9 * x6 + rnorm(n[1])

x7 <- runif(n[1])
y7 <- -x7
y7[y7 < -2] <- -1.5


# plots

gridExtra::grid.arrange(plots_(x,y), plots_(possum$totalL, possum$headL),
                        plots_(x2, y2), plots_(x3, y3), plots_(x4, y4),
                        plots_(x5, y5), plots_(x6, y6), plots_(x7, y7), ncol = 4)
Figura 1.9: Amostra de gráficos de dispersão e suas correlações. A primeira linha mostra variáveis com um relacionamento positivo, representado pela tendência para cima e para a direita. A segunda linha mostra variáveis com tendência negativa, em que um grande valor em uma variável é associado a um valor baixo na outra.
A correlação destina-se a quantificar a força de uma tendência linear. Tendências não-lineares, mesmo quando fortes, às vezes produzem correlações que não refletem a força do relacionamento. Veja três desses exemplos na Figura 1.10.
plots_  <- function(x,y){

    ggplot() +
    geom_point(aes(x, y), color = 'skyblue3') +
    theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
    theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank()) +
    annotate(geom = "text", x = mean(x), y = min(y),
             label = paste0('R = ', round(cor(x,y),2)), color = 'black')

}

set.seed(1)

n <- 50
x <- c(runif(n[1] - 2, -2, 2.2), 2, 2.1)
y <- -10 * x^2 + rnorm(n[1], sd = 5)

x2 <- c(runif(n[1] - 2, -20, 10.2), 2, 2.1)
y2 <- -x2^3 - 10 * x2^2 + 100 * x2 + rnorm(n[1], sd = 120)

x3 <- runif(n[1], -1, 4)
y3 <- 0.25 * (x3 > 3) - 0.5 * (x3 > 2) + 1.7 * (x3 > 1) + (x3 < 0)
x3 <- c(x3, 0, 0, 1, 1)
noise <- rnorm(n[1] + 4, sd = 0.071)
y3 <- c(y3, rep(0.5, 2), rep(1, 2)) + noise


gridExtra::grid.arrange(plots_(x,y), plots_(x2,y2), plots_(x3,y3), ncol = 3)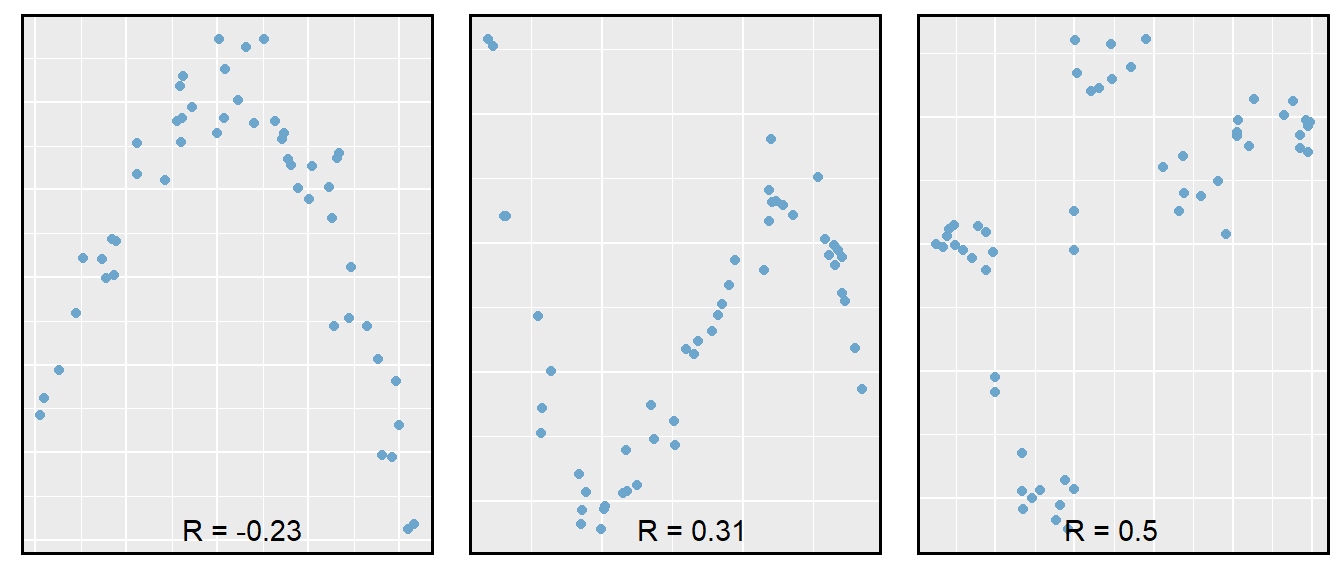
Figura 1.10: Amostra de gráficos de dispersão e suas correlações. Em cada caso, existe uma forte relação entre as variáveis. No entanto, a correlação não é muito forte e a relação não é linear.
1.2 Ajustando uma linha pela regressão de mínimos quadrados
A adaptação de modelos lineares visualmente está aberta a críticas, pois se baseia em uma preferência individual. Nesta seção, usamos regressão por mínimos quadrados como uma abordagem mais rigorosa.
Esta seção considera os dados da renda familiar e do gift aid de uma amostra aleatória de cinquenta alunos da turma de calouros de 2011 do Elmhurst College em Illinois5. Gift Aid é uma ajuda financeira que não precisa ser paga de volta, ao contrário de um empréstimo. Um gráfico de dispersão dos dados é mostrado na Figura 1.11 junto com dois ajustes lineares. As linhas seguem uma tendência negativa nos dados; os alunos que têm maior renda familiar tendem a ter menor ajuda da universidade.
library(openintro)
data(COL)
data(elmhurst)
d <- elmhurst

g <- lm(d$gift_aid ~ d$family_income)


loss <- function(a, b, d) {
  p <- a + b * d$family_income
  sum(abs(d$gift_aid - p))
}
a      <- round(g$coef[1], 2) + seq(-0.5, 0.5, 0.001)
b      <- round(g$coef[2], 3) + seq(-0.01, 0.01, 0.0001)
mins   <- c(a[1], b[1])
theMin <- loss(a[1], b[1], d)
pb     <- txtProgressBar(1, length(a), style=3)
for (i in 1:length(a)) {
  for (j in 1:length(b)) {
    hold <- loss(a[i], b[j], d)
    if (hold < theMin) {
      mins <- c(a[i],b[j])
      theMin <- hold
    }
  }
}

# elmhurstScatterW2Lines

ggplot(data = d, mapping = aes(family_income, gift_aid)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  labs(x = 'Renda Familiar ($1000s)', y = 'Auxílio-presente da \nuniversidade ($1000s)') +
  geom_abline(slope = mins[2], intercept = mins[1], linetype = 'dashed', size = 1) +
  geom_smooth(formula = y ~ x, se = FALSE, method = 'lm', color = 'black')
Figura 1.11: Auxílio presente e renda familiar para uma amostra aleatória de 50 alunos iniciantes do Elmhurst College. Duas linhas são ajustadas aos dados, sendo a linha sólida a regressão por mínimos quadrados.
1.2.1 Uma medida objetiva para encontrar a melhor linha
Começamos por pensar sobre o que queremos dizer com “melhor.” Matematicamente, queremos uma linha que tenha pequenos resíduos. Talvez nosso critério possa minimizar a soma das magnitudes residuais:
\[\begin{eqnarray} |e_1| + |e_2| + \dots + |e_n| \tag{1.3} \end{eqnarray}\]
o que poderíamos realizar com um programa de computador. A linha tracejada resultante mostrada na Figura 1.11 demonstra que esse ajuste pode ser bastante razoável. No entanto, uma prática mais comum é escolher a linha que minimiza a soma dos resíduos quadrados:
\[\begin{eqnarray} e_{1}^2 + e_{2}^2 + \dots + e_{n}^2 \tag{1.4} \end{eqnarray}\]
A linha que minimiza os mínimos quadrados é representada como a linha sólida na Figura 1.11. Isso é comumente chamado de linha de mínimos quadrados. A seguir estão três possíveis razões para escolher Critério (1.4) sobre o Critério (1.3):
É o método mais comumente usado.
Computar a linha com base no Critério (1.4) é muito mais fácil à mão e tem implementado na maioria dos softwares estatísticos.
Em muitas aplicações, um resíduo duas vezes maior que outro é quatro vezes mais problemático. Por exemplo, estar desviado por 4 é geralmente mais que duas vezes pior quanto estar desviado por 2. Usar o quadrado dos resíduos responde por essa discrepância.
As duas primeiras razões são em grande parte por tradição e conveniência; a última razão explica por que Critério (1.4) é geralmente mais útil.7
1.2.2 Condições para a linha de mínimos quadrados
Ao encaixar uma linha de mínimos quadrados, geralmente exigimos
Linearidade. Os dados devem mostrar uma tendência linear. Se houver uma tendência não linear (por exemplo, gráfico esquerdo da Figura 1.12), um método de regressão avançado de outro livro ou curso posterior deve ser aplicado.
Resíduos quase normais. Geralmente os resíduos devem ser quase normais. Quando esta condição é considerada irracional, geralmente é por causa de discrepâncias ou preocupações sobre pontos influentes, que discutiremos com mais profundidade na Seção 1.3. Um exemplo de resíduos não normais é mostrado no segundo gráfico da Figura 1.12.
Variabilidade constante. A variabilidade de pontos ao redor da linha dos mínimos quadrados permanece praticamente constante. Um exemplo de variabilidade não constante é mostrado no terceiro gráfico da Figura 1.12.
Observações independentes. Seja cauteloso ao aplicar a regressão a dados de séries temporais, que são observações sequenciais no tempo, como o preço de uma ação por dia. Tais dados podem ter uma estrutura subjacente que deve ser considerada em um modelo e análise. Um exemplo de um conjunto de dados em que observações sucessivas não são independentes é mostrado no quarto gráfico da Figura 1.12. Existem também outros casos em que as correlações dentro dos dados são importantes.
pls <- function(x, y){
  g <- lm(y ~ x)

  ggplot(mapping = aes(x,g$residuals)) +
    theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
    geom_point(color = 'skyblue3') +
    geom_hline(yintercept = 0, linetype = 'dashed') +
    theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank())

}


# load the makeTube function (ch7 folder)

set.seed(1)
x <- runif(100)
y <- 25 * x - 20 * x^2 + rnorm(length(x), sd = 1.5)

p1 <- ggplot(mapping = aes(x,y)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  geom_smooth(method = 'lm', se = FALSE, formula = y ~ x, color = 'black') +
  theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank())

set.seed(2)
x2 <- c(-0.6, -0.46, -0.091, runif(97))
y2 <- 25 * x2 + rnorm(length(x2))
y2[2] <- y2[2] + 8
y2[1] <- y2[1] + 1

p2 <- ggplot(mapping = aes(x2,y2)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  geom_smooth(method = 'lm', se = FALSE, formula = y ~ x, color = 'black', linetype = 'dashed') +
  theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank())

set.seed(3)
x3 <- runif(100)
y3 <- 5 * x3 + rnorm(length(x3), sd = x3)

p3 <- ggplot(mapping = aes(x3,y3)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  geom_smooth(method = 'lm', se = FALSE, formula = y ~ x, color = 'black', linetype = 'dashed') +
  theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank())

require(Ecdat)
data(Macrodat)


p4 <- ggplot(mapping = aes(1:length(Macrodat[,1]),as.numeric(Macrodat[,1]))) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  geom_smooth(method = 'lm', se = FALSE, formula = y ~ x, color = 'black', linetype = 'dashed') +
  theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank())


gridExtra::grid.arrange(p1, p2, p3, p4, pls(x,y), pls(x2,y2), pls(x3,y3),
                        pls(x = 1:length(Macrodat[,1]),y = as.numeric(Macrodat[,1])), ncol = 4)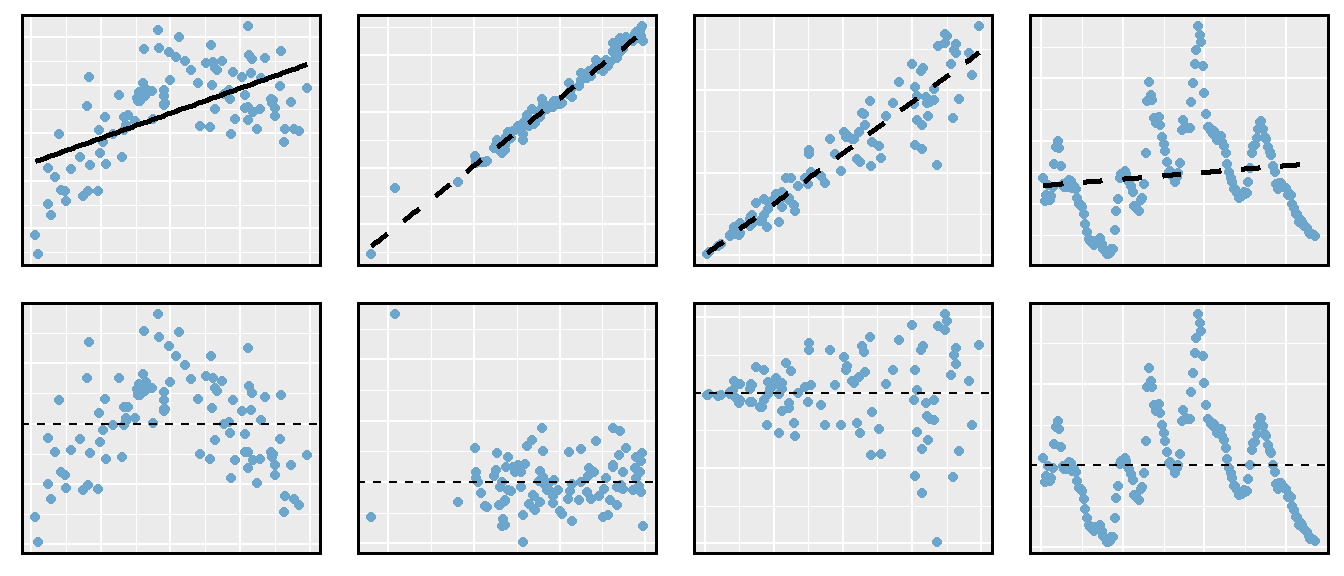
Figura 1.12: Quatro exemplos mostrando quando os métodos neste capítulo são insuficientes para aplicar aos dados. No gráfico esquerdo, uma linha reta não se ajusta aos dados. No segundo gráfico, existem outliers; dois pontos à esquerda estão relativamente distantes do resto dos dados, e um desses pontos está muito longe da linha. No terceiro gráfico, a variabilidade dos dados ao redor da linha aumenta com valores maiores de x. No último gráfico, é mostrado um conjunto de dados de séries temporais, em que as observações sucessivas são altamente correlacionadas.
1.2.3 Encontrar a linha dos mínimos quadrados
Para os dados de Elmhurst, poderíamos escrever a equação da linha de regressão de mínimos quadrados como
\[\begin{eqnarray*} \widehat{ajuda} = \beta_0 + \beta_{1}\times ganho\_\hspace{0.3mm}familiar \end{eqnarray*}\]
Aqui, a equação é configurada para prever o gift-aid com base na renda familiar de um aluno, o que seria útil para os alunos que considerassem Elmhurst. Esses dois valores, \(\beta_0\) e \(\beta_1\), são os parâmetros da linha de regressão.
Como nos Capítulos 4-6, os parâmetros são estimados usando dados observados. Na prática, essa estimativa é feita usando um computador da mesma forma que outras estimativas, como uma média amostral, podem ser estimadas usando um computador ou uma calculadora. No entanto, também podemos encontrar as estimativas dos parâmetros aplicando duas propriedades da linha de mínimos quadrados:
- A inclinação da linha dos mínimos quadrados pode ser estimada por
\[\begin{eqnarray} b_1 = \frac{s_y}{s_x} R \tag{1.5} \end{eqnarray}\]
onde \(R\) é a correlação entre as duas variáveis, e \(s_x\) e \(s_y\) são os desvios padrão da amostra da variável explicativa (variável no eixo horizontal) e resposta (variável no eixo vertical), respectivamente.
- Se \(\bar{x}\) for a média da variável horizontal (dos dados) e \(\bar{y}\) é a média da variável vertical, então o ponto \((\bar{x}, \bar{y})\) está nos mínimos quadrados linha.
Usamos \(b_0\) e \(b_1\) para representar as estimativas pontuais dos parâmetros \(\beta_0\) e \(\beta_1\).
table1 <- matrix(c(101.8, 19.94, 63.2, 5.46, ' ', 'R = -0.499'), ncol = 2, nrow = 3, byrow = TRUE)
colnames(table1) <- c('renda familiar, em $1000s (x)', 'gift aid, em $1000s (y)')
rownames(table1) <- c('média', 'dp', '')

knitr::kable(table1, align = 'r', caption = 'Estatísticas resumidas para renda familiar e gift aid.')| renda familiar, em $1000s (x) | gift aid, em $1000s (y) | |
|---|---|---|
| média | 101.8 | 19.94 |
| dp | 63.2 | 5.46 |
| R = -0.499 |
Você pode se lembrar da forma de uma linha da aula de matemática (outra forma comum é com coeficiente linear e angular). Dada a inclinação de uma linha e um ponto na linha, \((x_0, y_0)\), a equação da linha pode ser escrita como
\[\begin{eqnarray} y - y_0 = Inclinação \times (x - x_0) \tag{1.6} \end{eqnarray}\]
Um exercício comum para se tornar mais familiarizado com os fundamentos da regressão de mínimos quadrados é usar as estatísticas de resumo básicas e a forma ponto e inclinação para produzir a linha de mínimos quadrados.
Identificando a linha dos mínimos quadrados a partir das estatísticas de resumo: Passos para identificar a linha de mínimos quadrados a partir das estatísticas de resumo:
Estimar o parâmetro de inclinação, \(b_1\), usando a Equação (1.5).
Observando que o ponto \((\bar{x}, \bar{y})\) está na linha de mínimos quadrados, use \(x_0=\bar{x}\) e \(y_0=\bar{y}\) junto com a inclinação \(b_1\) na equação da reta: \[y - \bar{y} = b_1 (x - \bar{x})\]
Simplifique a equação.
Aplique a equação da reta usando \((101.8, 19.94)\) e a inclinação \(b_1 = -0,0431\):
\[\begin{align*} y - y_0 &= b_1 (x - x_0) \\ y - 19.94 &= -0.0431(x - 101.8) \end{align*}\]
Expandindo o lado direito e, em seguida, adicionando 19,94 para cada lado, a equação simplifica: \[\widehat{auxilio} = 24.3 - 0.0431 \times renda\_\hspace{0.3mm}familiar\] Aqui nós substituímos \(y\) por \(\widehat{auxilio}\) e \(x\) por \(renda\_\hspace{0.3mm}familiar\) para colocar a equação no contexto.
Mencionamos anteriormente que um computador é geralmente usado para calcular a linha de mínimos quadrados. Uma tabela de resumo baseada na saída do computador é mostrada na Tabela 1.2 para os dados do Elmhurst. A primeira coluna de números fornece estimativas para \({b} _0\) e \({b} _1\), respectivamente. Compare-os com o resultado do Exemplo 1.3.
g <- lm(d$gift_aid ~ d$family_income)

temp <- data.frame(summary(g)$coefficients)
colnames(temp) <- c('Estimativa', 'Erro Padrão', 'valor t', 'Pr(>|t|)')
rownames(temp) <- c('(Interceptio)', 'Renda Familiar')
knitr::kable(temp, align = 'c', caption = 'Resumo dos mínimos quadrados adequados aos dados do Elmhurst.')| Estimativa | Erro Padrão | valor t | Pr(>|t|) | |
|---|---|---|---|---|
| (Interceptio) | 24.3193290 | 1.2914503 | 18.831022 | 0.0000000 |
| Renda Familiar | -0.0430717 | 0.0108095 | -3.984621 | 0.0002289 |
Vamos descrever o significado das colunas usando a segunda linha, que corresponde a \(\beta_1\). A primeira coluna fornece a estimativa pontual para \(\beta_1\), como calculamos em um exemplo anterior: -0,0431. A segunda coluna é um erro padrão para esta estimativa pontual: 0,0108. A terceira coluna é uma estatística do teste-\(t\) para a hipótese nula de que \(\beta_1=0\): \(T = -3,98\). A última coluna é o p-valor para a estatística do teste-\(t\) para a hipótese nula \(\beta_1=0\) e uma hipótese alternativa bilateral: 0,0002. Vamos entrar em mais desses detalhes na Seção 1.4.
Ele pode usá-lo como uma estimativa, embora alguns qualificadores sobre essa abordagem sejam importantes. Primeiro, todos os dados são provenientes de uma turma de primeiro ano, e a forma como a ajuda é determinada pela universidade pode mudar de ano para ano. Em segundo lugar, a equação fornecerá uma estimativa imperfeita. Enquanto a equação linear é boa em capturar a tendência nos dados, nenhuma ajuda individual do aluno será perfeitamente prevista.
1.2.4 Interpretando estimativas de parâmetros da linha de regressão
A interpretação de parâmetros em um modelo de regressão é frequentemente uma das etapas mais importantes da análise.
Interpretar o parâmetro de inclinação é útil em quase qualquer aplicação. Para cada adicional de $1,000 de renda familiar, esperamos que um aluno receba uma diferença líquida de \(\$\text{1,000}\times (-0.0431) = -\$43.10\) em ajuda, em média, ou seja, $43,10 menos. Note que uma renda familiar maior corresponde a menos ajuda, pois o coeficiente de renda familiar é negativo no modelo. Devemos ser cautelosos nessa interpretação: embora exista uma associação real, não podemos interpretar uma conexão causal entre as variáveis porque esses dados são observacionais. Ou seja, aumentar a renda familiar de um aluno pode não causar a queda da ajuda ao aluno. (Seria razoável entrar em contato com a faculdade e perguntar se a relação é causal, ou seja, se as decisões de ajuda da Elmhurst College são parcialmente baseadas na renda familiar dos alunos.)
O intercepto estimado em \(b_0=24,3\) (em $1000s) descreve a ajuda média se a família de um aluno não tiver renda. O significado do intercepto é relevante para esta aplicação, uma vez que a renda familiar para alguns alunos do Elmhurst é de $0. Em outras aplicações, o intercepto pode ter pouco ou nenhum valor prático se não houver observações em que \(x\) é próximo de zero.
Interpretando parâmetros estimados por mínimos quadrados: A inclinação descreve a diferença estimada na variável \(y\) se a variável explicativa \(x\) para o aumento de uma unidade. O intercepto descreve o resultado médio de \(y\) se \(x=0\) e o modelo linear é válido até \(x = 0\), o que em muitas aplicações não é o caso.
1.2.5 A extrapolação é traiçoeira
Quando aquelas tempestades de neve atingiram a costa leste neste inverno, provou para minha satisfação que o aquecimento global era uma fraude. Aquela neve estava gelada. Mas em uma tendência alarmante, as temperaturas nesta primavera aumentaram. Considere isto: em 6 de fevereiro foi de 10 graus. Hoje atingiu quase 80. A este ritmo, até agosto será de 220 graus. Então, claramente pessoal, o debate sobre o clima continua. - Stephen Colbert, 6 de Abril de 2010.11
Modelos lineares podem ser usados para aproximar o relacionamento entre duas variáveis. No entanto, esses modelos têm limitações reais. A regressão linear é simplesmente uma estrutura de modelagem. A verdade é quase sempre muito mais complexa do que a nossa linha simples. Por exemplo, não sabemos como os dados fora da nossa janela limitada se comportarão.
Lembre-se que as unidades de renda familiar estão em $1000s, então queremos calcular o auxílio para \(renda\_\hspace{0.3mm}familiar = 1000\):
\[\begin{align*} 24,3 – 0,0431\times renda\_\hspace{0.3mm}familiar = 24,3 – 0,0431\times 1000 = -18,8 \end{align*}\]
O modelo prevê que esse aluno irá ter -$18,800 em auxílio (!). O Elmhurst College não pode exigir que os estudantes paguem uma taxa adicional para pagar a matrícula.
A aplicação de uma estimativa de modelo a valores fora do domínio dos dados originais é denominada extrapolação. Geralmente, um modelo linear é apenas uma aproximação da relação real entre duas variáveis. Se extrapolarmos, estamos apostando que a relação linear aproximada será válida em lugares onde não foi analisada.
1.2.6 Usando \(R^2\) para descrever a força de um ajuste
Avaliamos a força da relação linear entre duas variáveis anteriormente usando a correlação, \(R\). No entanto, é mais comum explicar a força de um ajuste linear usando \(R^2\), chamado R-quadrado (\(R^2\)). Se fornecido com um modelo linear, gostaríamos de descrever o quão próximo o conjunto de dados está do ajuste linear.
ggplot(data = d, mapping = aes(family_income, gift_aid)) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = 'skyblue3') +
  labs(x = 'Renda Familiar ($1000s)', y = 'Auxílio-presente da \nuniversidade ($1000s)') +
  geom_smooth(formula = y ~ x, se = FALSE, method = 'lm', color = 'black')
Figura 1.13: Gift aid e renda familiar para uma amostra aleatória de 50 estudantes calouros do Elmhurst College, mostrada com a linha de regressão de mínimos quadrados.
O \(R^2\) de um modelo linear descreve a quantidade de variação na resposta que é explicada pela linha de mínimos quadrados. Por exemplo, considere os dados de Elmhurst, mostrados na Figura 1.13. A variância da variável resposta, a ajuda recebida, é \(s_{aid}^2=29,8\). No entanto, se aplicarmos nossa linha de mínimos quadrados, esse modelo reduz nossa incerteza na previsão de ajuda usando a renda familiar de um aluno. A variabilidade nos resíduos descreve quanta variação permanece após o uso do modelo: \(s_{_{RES}}^2 = 22.4\). Em suma, houve uma redução de
\[\frac{s_{aid}^2 - s_{_{RES}}^2}{s_{aid}^2} = \frac{29,8 – 22,4}{29,8} = \frac{7,5}{29,8} = 0,25\]
ou cerca de 25% na variação dos dados usando informações sobre a renda familiar para prever a ajuda usando um modelo linear. Isso corresponde exatamente ao valor de R-quadrado:
\[\begin{align*} R &= -0,499 &R^2 &= 0,25 \end{align*}\]
1.2.7 Preditores categóricos com dois níveis
Variáveis categóricas também são úteis na previsão de resultados. Aqui nós consideramos um preditor categórico com dois níveis (lembre-se que um nível é o mesmo que uma categoria). Vamos considerar os leilões Ebay para um videogame, Mario Kart para o Nintendo Wii, onde foram registrados o preço total do leilão e as condições do jogo13. Aqui, queremos prever o preço total com base na condição do jogo, que recebe valores usado (0) e novo (1). Um gráfico dos dados do leilão é mostrado na Figura 1.14.
library(openintro)
data(COL)
data(marioKart)
mk      <- marioKart[marioKart$totalPr < 100, ]
mk$cond <- relevel(mk$cond, "used")
cond <- as.numeric(ifelse(mk$cond == "new", 1, 0))

ggplot() +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(aes(as.factor(cond), mk$totalPr), color = 'skyblue3') +
  labs(y = 'Preço Total', x = NULL) +
  theme(axis.text.x = element_blank(), axis.ticks.x = element_blank()) +
  annotate(geom = "text", x = 1.6, y = 35,
           label = expression(widehat(price) *" = 42.87 + 10.90 x cond_new"))
Figura 1.14: Preços totais de leilão para o videogame Mario Kart, divididos em jogos de condição usados (x = 0) e novos (x = 1). A linha de regressão dos mínimos quadrados também é mostrada.
Para incorporar a variável de condição de jogo em uma equação de regressão, devemos converter as categorias em uma forma numérica. Faremos isso usando uma variável indicadora chamada cond_nova, que leva valor 1 quando o jogo é novo e 0 quando o jogo é usado. Usando esta variável indicadora, o modelo linear pode ser escrito como
\[\begin{align*} \widehat{preço} = \beta_0 + \beta_1 \times cond\_\hspace{0.3mm}nova \end{align*}\]
O modelo ajustado está resumido na Tabela 1.3, e o modelo com seus parâmetros estimados é dado como
\[\begin{align*} \widehat{preço} = 42.87 + 10.90 \times cond\_\hspace{0.3mm}nova \end{align*}\]
Para preditores categóricos com apenas dois níveis, a suposição de linearidade será sempre satisfeita. No entanto, devemos avaliar se os resíduos em cada grupo são aproximadamente normais e têm variância aproximadamente igual. Como pode ser visto na Figura 1.14, ambas as condições são razoavelmente satisfeitas pelos dados do leilão.
g <- lm(mk$totalPr ~ cond)

temp <- data.frame(summary(g)$coefficients)
colnames(temp) <- c('Estimativa', 'Erro Padrão', 'valor t', 'Pr(>|t|)')
rownames(temp) <- c('(Interceptio)', 'Condição do Jogo')
knitr::kable(temp, align = 'c',
caption = 'Resumo de regressão por mínimos quadrados para o preço final do leilão em relação à condição do jogo.', digits = 2)| Estimativa | Erro Padrão | valor t | Pr(>|t|) | |
|---|---|---|---|---|
| (Interceptio) | 42.87 | 0.81 | 52.67 | 0 |
| Condição do Jogo | 10.90 | 1.26 | 8.66 | 0 |
O intercepto é o preço estimado quando a condição do jogo leva o valor 0, ou seja, quando o jogo está em condição usada. Ou seja, o preço médio de venda de uma versão usada do jogo é $42,87.
A inclinação indica que, em média, os novos jogos são vendidos por cerca de $10,90 a mais que os jogos usados.
Interpretando estimativas do modelo para preditores categóricos.: A intersecção estimada é o valor da variável de resposta para a primeira categoria (ou seja, a categoria correspondente a um valor indicativo de 0). A inclinação estimada é a mudança média na variável de resposta entre as duas categorias.
Vamos elaborar mais sobre os dados do leilão do Ebay no próximo capítulo, onde examinamos a influência de muitas variáveis preditoras simultaneamente usando a regressão múltipla. Na regressão múltipla, consideraremos a associação do preço de leilão em relação a cada variável enquanto controlamos a influência de outras variáveis. Isso é especialmente importante, já que alguns dos preditores estão associados. Por exemplo, leilões com jogos novos também costumam vir com mais acessórios.
1.3 Tipos de outliers em regressão linear
Nesta seção, identificamos critérios para determinar quais outliers são importantes e influentes. Outliers na regressão são observações que estão longe da “nuvem” de pontos. Esses pontos são especialmente importantes porque podem ter uma forte influência na linha de mínimos quadrados.
pls <- function(x, y){
  g <- lm(y ~ x)

  ggplot(mapping = aes(x,g$residuals)) +
    theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
    geom_point(color = 'skyblue3') +
    geom_hline(yintercept = 0, linetype = 'dashed') +
    theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank())

}

n <- c(50, 25, 78, 55, 70, 150)
m <- c(12, -4, 7, -19, 0, 40)

xr <- list(0.3, 2, 1.42,
           runif(4, 1.45, 1.55),
           5.78, -0.6)

yr <- list(-4, -8, 19,
           c(-17, -20, -21, -19),
           12, -23.2)


graf <- list()
resf <- list()

for(i in 1:6){
  x <- runif(n[i])
  y <- m[i] * x + rnorm(n[i])
  x <- c(x, xr[[i]])
  y <- c(y, yr[[i]])

  graf[[i]] <- ggplot(mapping = aes(x,y)) +
    theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
    geom_point(color = 'skyblue3') +
    theme(axis.text = element_blank(), axis.ticks = element_blank(), axis.title = element_blank()) +
    ggtitle(paste0('(',i,')')) +
    theme(plot.title = element_text(hjust = 0.5))

  resf[[i]] <- pls(x,y)
}

gridExtra::grid.arrange(graf[[1]], graf[[2]], graf[[3]],
                        resf[[1]], resf[[2]], resf[[3]],
                        graf[[4]], graf[[5]], graf[[6]],
                        resf[[4]], resf[[5]], resf[[6]], ncol = 3)
Figura 1.15: Seis gráficos, cada uma com uma linha de mínimos quadrados e gráfico de resíduos. Todos os conjuntos de dados têm pelo menos um outlier.
(1) Existe um outlier longe dos outros pontos, embora pareça apenas influenciar levemente a reta.
(2) Há um outlier à direita, embora esteja bem próximo da linha de mínimos quadrados, o que sugere que não foi muito influente.
(3) Há um ponto longe da nuvem, e este outlier parece puxar a linha de mínimos quadrados para a direita; examine como a linha ao redor da nuvem primária não parece se encaixar muito bem.
(4) Existe uma nuvem primária e uma pequena nuvem secundária de quatro outliers. A nuvem secundária parece estar influenciando fortemente a linha, fazendo com que a linha de mínimos quadrada se encaixe mal em quase todos os lugares. Pode haver uma explicação interessante para as nuvens duplas, que é algo que poderia ser investigado.
(5) Não há uma tendência óbvia na nuvem principal de pontos e o outlier à direita parece controlar amplamente a inclinação da linha de mínimos quadrados.
(6) Existe um outlier longe da nuvem, no entanto, cai bastante perto da linha de mínimos quadrados e não parece ser muito influente.
Examine os gráficos de resíduos na Figura 1.15. Você provavelmente descobrirá que há alguma tendência nas nuvens principais de (3) e (4). Nestes casos, os outliers influenciaram a inclinação das linhas de mínimos quadrados. Em (5), os dados sem tendência clara foram atribuídos a uma linha com uma tendência grande simplesmente devido a um outlier (!).
Alavancas: Pontos que caem horizontalmente para longe do centro da nuvem tendem a puxar mais forte na linha, então nós os chamamos de pontos com alta alavancagem.
Pontos que caem horizontalmente longe da linha são pontos de alta alavancagem; esses pontos podem influenciar fortemente a inclinação da linha de mínimos quadrados. Se um desses pontos de alavancagem alta parece realmente influenciar na inclinação da linha – como nos casos (3), (4) e (5) do Exemplo 1.9 – então chamamos de ponto influente. Normalmente, podemos dizer que um ponto é influente se, se tivéssemos ajustado a linha sem ele, o ponto influente teria sido extraordinariamente distante da linha de mínimos quadrados.
É tentador remover os outliers. Não faça isso sem um bom motivo. Modelos que ignoram casos excepcionais (e interessantes) geralmente apresentam desempenho insatisfatório. Por exemplo, se uma firma financeira ignorasse as maiores oscilações do mercado – os “outliers” – eles logo iriam à falência fazendo investimentos mal pensados.
Não ignore outliers ao montar um modelo final: Se houver valores discrepantes nos dados, eles não devem ser removidos ou ignorados sem um bom motivo. Seja qual for o modelo final adequado aos dados, não seria muito útil ignorar os casos mais excepcionais.
Outliers para um preditor categórico com dois níveis: Seja cauteloso ao usar um preditor categórico quando um dos níveis tiver poucas observações. Quando isso acontece, essas poucas observações se tornam pontos influentes.
1.4 Inferência para regressão linear
Nesta seção, discutimos a incerteza nas estimativas da inclinação e do intercepto de y para uma linha de regressão. Assim como identificamos erros-padrão para estimativas pontuais nos capítulos anteriores, primeiro discutimos erros-padrão para essas novas estimativas. No entanto, no caso de regressão, identificaremos erros padrão usando software estatístico.
1.4.1 Eleições de meio de mandato e desemprego
As eleições para os membros da Câmara dos Representantes dos Estados Unidos ocorrem a cada dois anos, coincidindo a cada quatro anos com a eleição presidencial dos EUA. O conjunto de eleições da Câmara que ocorre durante o meio de um mandato presidencial é chamado de midterm elections. No sistema bipartidário americano, uma teoria política sugere que quanto maior a taxa de desemprego, pior o partido do presidente fará nas eleições de meio de mandato.
Para avaliar a validade dessa afirmação, podemos compilar dados históricos e procurar uma conexão. Consideramos todas as eleições intercalares de 1898 a 2010, com exceção das eleições durante a Grande Depressão. A Figura 1.16 mostra estes dados e a linha de regressão de mínimos quadrados:
\[\begin{align*} &\text{% mudança em assentos da casa para o partido do presidente} \\ &\qquad\qquad= -6,71 – 1,00\times \text{(taxa de desemprego)} \end{align*}\]
Consideramos a variação percentual no número de assentos do partido do Presidente (por exemplo, variação percentual no número de assentos para os democratas em 2010) em relação à taxa de desemprego.
Examinando os dados, não há desvios evidentes da linearidade, da condição de variância constante ou da normalidade dos resíduos (embora não examinemos aqui um gráfico de probabilidade normal). Enquanto os dados são coletados sequencialmente, uma análise separada foi usada para verificar qualquer correlação aparente entre observações sucessivas; nenhuma correlação foi encontrada.
library(openintro)
data(unempl)
data(house)
data(president)
h <- house
pres <- president


year   <- seq(1898, 2010, 4) + 1
n      <- length(year)
unemp  <- rep(0, n)
change <- rep(0, n)
presid <- rep("", n)
party  <- rep("", n)

for (i in 1:n) {
  urow <- which(unempl$year == year[i]-1)
  if (i < n) {
    prow <- which(pres$end > year[i])[1]
  } else {
    prow <- which(pres$potus == "Barack Obama")
  }
  hrow <- which(h$yearEnd >= year[i])[1]
  party[i] <- as.character(pres$party[prow])
  if (substr(h$p1[hrow], 1, 5) == substr(party[i], 1, 5)) {
    oldHouse <- h$np1[hrow] / h$seats[hrow]
  } else {
    oldHouse <- h$np2[hrow] / h$seats[hrow]
  }
  if (substr(h$p1[hrow + 1], 1, 5) == substr(party[i], 1, 5)) {
    newHouse <- h$np1[hrow + 1] / h$seats[hrow + 1]
  } else {
    newHouse <- h$np2[hrow + 1] / h$seats[hrow + 1]
  }
  change[i] <- (newHouse - oldHouse) / oldHouse * 100
  presid[i] <- as.character(pres$potus[prow])
  unemp[i]  <- unempl$unemp[urow]
}

unemployPres <- data.frame(year = year,
                           potus = presid,
                           party = party,
                           unemp = unemp,
                           change = change)


th <- !year %in% c(1935, 1939)
repub <- (unemployPres$party[th] == "Republican")

ggplot(mapping = aes(unemployPres$unemp[th], unemployPres$change[th])) +
  theme(panel.border = element_rect(colour = "black", fill = NA, size = 1)) +
  geom_point(color = ifelse(repub == 'TRUE', 'tomato', 'skyblue3')) +
  labs(x = 'Percentual de desemprego', y = 'Variação percentual de
       assentos do partido do presidente
       na Câmara dos Deputados') +
  geom_smooth(formula = y ~ x, method = 'lm', se = FALSE, color = 'black')
Figura 1.16: A porcentagem de mudança nas cadeiras da Câmara para o partido do presidente em cada eleição de 1898 a 2010 foi traçada contra a taxa de desemprego. Os dois pontos para a Grande Depressão foram removidos e uma linha de regressão de mínimos quadrados foi ajustada aos dados.
Há uma inclinação negativa na linha mostrada na Figura 1.16. No entanto, esta inclinação (e intercepto) são apenas estimativas dos valores dos parâmetros. Poderíamos nos perguntar: essa evidência convincente de que o modelo linear “verdadeiro” tem uma inclinação negativa? Ou seja, os dados fornecem fortes evidências de que a teoria política é exata? Podemos enquadrar essa investigação em um teste de hipótese estatística unilateral:
\(H_0\): \(\beta_1 = 0\). O verdadeiro modelo linear tem inclinação zero.
\(H_1\): \(\beta_1 < 0\). O modelo linear verdadeiro tem uma inclinação menor que zero. Quanto maior o desemprego, maior a perda para o partido do presidente na Câmara dos Representantes.
Nós rejeitaríamos \(H_0\) em favor de \(H_1\) se os dados fornecerem fortes evidências de que o parâmetro de inclinação real é menor que zero. Para avaliar as hipóteses, identificamos um erro padrão para a estimativa, calculamos uma estatística de teste apropriada e identificamos o p-valor.
1.4.2 Entendendo a saída de regressão do software
Assim como outras estimativas pontuais que vimos antes, podemos calcular um erro padrão e testar a estatística para \(b_1\). Em geral, rotularemos a estatística de teste usando um \(T\), já que ela segue a distribuição \(t\).
Contaremos com software estatístico para calcular o erro padrão e deixar a explicação de como esse erro padrão é determinado para um segundo ou terceiro curso de estatística. A Tabela 1.4 mostra a saída de software para a linha de regressão de mínimos quadrados na Figura 1.16. A linha chamada desempregado representa a informação para a inclinação, que é o coeficiente da variável desemprego.
temp <- summary(lm(change ~ unemp, unemployPres))$coefficients
colnames(temp) <- c('Estimativa', 'Erro Padrão', 'valor t', 'Pr(>|t|)')
rownames(temp) <- c('(Intercepto)', 'Desemprego')

knitr::kable(temp, align = 'r', digits = 2,
caption = 'Saída do software estatístico para a linha de regressão que modela as perdas eleitorais a médio prazo para o partido do Presidente como resposta ao desemprego.')| Estimativa | Erro Padrão | valor t | Pr(>|t|) | |
|---|---|---|---|---|
| (Intercepto) | -12.68 | 3.56 | -3.56 | 0.00 |
| Desemprego | 0.04 | 0.45 | 0.08 | 0.93 |
As entradas na primeira coluna representam as estimativas de mínimos quadrados, \(b_0\) e \(b_1\), e os valores na segunda coluna correspondem aos erros padrão de cada estimativa.
Anteriormente, usamos uma estatística de teste-\(t\) para testes de hipóteses no contexto de dados numéricos. Regressão é muito semelhante. Nas hipóteses que consideramos, o valor nulo para a inclinação é 0, então podemos calcular a estatística de teste usando a fórmula do teste T (ou Z):
\[\begin{align*} T = \frac{\text{estimativa} - \text{valor nulo}}{\text{EP}} = \frac{-1.0010 - 0}{0.8717} = -1.15 \end{align*}\]
Podemos procurar o p-valor unilateral – mostrado na Figura 1.17 – usando a tabela de probabilidades para a distribuição-\(t\).
set.seed(1)
m <- 0
s <- 0.8717
X <- m + s * seq(-4, 4, 0.01)
Y <- dnorm(X, m, s)

gg   <- data.frame(X,Y)

ggplot(data = gg, mapping = aes(x = X, y = Y)) +
  geom_linerange(data = gg[gg$X < -1.0010,], aes(X, ymin = 0, ymax = Y), color = "skyblue3") +
  geom_path(size = 1) +
  scale_x_continuous(breaks = round(seq(m - 3*s, m + 3*s, s),2)) +
  labs(x = NULL, y = NULL) +
  theme(axis.text.y = element_blank(), axis.ticks.y = element_blank()) +
  geom_hline(yintercept = 0) +
  theme(panel.border = element_rect(colour = "black", fill=NA, size=1))
Figura 1.17: A distribuição mostrada aqui é a distribuição amostral para b1, se a hipótese nula for verdadeira. A cauda sombreada representa o p-valor para o teste de hipótese que avalia se há evidência convincente de que o desemprego mais elevado corresponde a uma maior perda de assentos na Câmara para o partido do Presidente durante uma eleição de meio de mandato.
Olhando na linha de 25 graus de liberdade, Vemos que o valor absoluto da estatística de teste é menor do que qualquer valor listado, o que significa que a área da cauda e, portanto, também o p-valor é maior que 0,100 (uma cauda!). Como o p-valor é tão grande, deixamos de rejeitar a hipótese nula. Ou seja, os dados não fornecem evidências convincentes de que uma taxa de desemprego mais alta tenha qualquer relação com perdas menores ou maiores para o partido do Presidente na Câmara dos Deputados nas eleições de meio de mandato.
Poderíamos ter identificado o teste-\(t\) estatístico por software na Tabela 1.4, mostrado na segunda linha (desempregado) e terceira coluna (valor t). A entrada na segunda linha e última coluna na Tabela 1.4 representa o p-valor para o teste de hipóteses bilateral, em que o valor nulo é zero. O teste unilateral correspondente a metade do p-valor listado.
Inferência para regressão: Geralmente, utilizamos software estatístico para identificar estimativas pontuais e erros padrão para parâmetros de uma linha de regressão. Depois de verificar as condições para ajustar uma reta, podemos usar os métodos aprendidos anteriormente para a distribuição-\(t\) para criar intervalos de confiança para parâmetros de regressão ou para avaliar testes de hipóteses.
Não use descuidadamente o p-valor da saída de regressão: A última coluna na saída de regressão geralmente lista p-valores para uma hipótese particular: um teste bilateral onde o valor nulo é zero. Se o seu teste for unilateral e a estimativa pontual estiver na direção de \(H_1\), você poderá reduzir pela metade o p-valor do software para obter a área unilateral. Se nenhum desses cenários corresponder ao seu teste de hipótese, tenha cuidado ao usar a saída de software para obter o p-valor.
Enquanto a relação entre as variáveis não é perfeita, há uma evidente tendência decrescente nos dados. Isso sugere que o teste de hipótese rejeitará a declaração nula de que a inclinação é zero.
Prática Orientada 1.10 A Tabela 1.5 mostra a saída de um software estatístico para o ajuste da linha de regressão de mínimos quadrados mostrada na Figura 1.13. Use essa saída para avaliar formalmente as hipóteses a seguir.
\(H_0\): O verdadeiro coeficiente de renda familiar é zero.
\(H_1\): O coeficiente verdadeiro para a renda familiar não é zero.15g <- lm(gift_aid ~ family_income, d)
tempor <- summary(g)$coefficients
colnames(tempor) <- c('Estimativa', 'Erro Padrão', 'Valor t', 'Pr(>|t|)')
rownames(tempor) <- c('(Intercepto)', 'Renda Familiar')
knitr::kable(tempor, align = 'r', digits = 2, caption = 'Resumo dos mínimos quadrados adequados aos dados do Elmhurst College.')| Estimativa | Erro Padrão | Valor t | Pr(>|t|) | |
|---|---|---|---|---|
| (Intercepto) | 24.32 | 1.29 | 18.83 | 0 |
| Renda Familiar | -0.04 | 0.01 | -3.98 | 0 |
Sempre cheque suposições: Se as condições para ajustar a linha de regressão não forem válidas, os métodos apresentados aqui não deverão ser aplicados. O pressuposto padrão de erro ou distribuição da estimativa pontual – considerado normal ao aplicar o teste-\(t\) estatístico – pode não ser válido.

This work is licensed under a Creative Commons Attribution-ShareAlike 3.0 Unported License.
Se um modelo subestimar uma observação, então a estimativa do modelo está abaixo da real. O resíduo, que é o valor de observação real menos a estimativa do modelo, deve então ser positivo. O oposto é verdadeiro quando o modelo superestima a observação: o resíduo é negativo.↩︎
(\(+\)) Primeiro calcule o valor previsto com base no modelo: \[\hat{y}_{+} = 41+0,59x_{+} = 41+0,59\times 85,0 = 91,15\] Então o resíduo é dado por \[e_{+} = y_{+} - \hat{y}_{+} = 98,6-91,15=7,45.\] Isso foi perto da estimativa anterior de 7. (\(\triangle\)) \(\hat{y}_{\triangle} = 41+0,59x_{\triangle} = 97,3\). \(e_{\triangle} = y_{\triangle} - \hat{y}_{\triangle} = -3,3\), perto da estimativa de -4.↩︎
Formalmente, podemos calcular a correlação para observações \((x_1, y_1)\), \((x_2, y_2)\), …, \((x_n, y_n)\) usando a fórmula R = \(\frac{1}{n-1}\sum_{i=1}^{n} \frac{x_i-\bar{x}}{s_x}\frac{y_i-\bar{y}}{s_y}\), onde \(\bar{x}\), \(\bar{y}\), \(s_x\), e \(s_y\) são as médias amostrais e os desvios padrão para cada variável.↩︎
Deixaremos para você desenhar as linhas. Em geral, as linhas desenhadas devem estar próximas da maioria dos pontos e refletir as tendências gerais nos dados.↩︎
Estes dados foram coletados de uma tabela de dados para todos os calouros da turma de 2011 do Elmhurst College. Acompanhou um artigo intitulado O que os estudantes realmente pagam para ir para a faculdade publicado online pela A Crônica da Educação Superior↩︎
Rendimentos familiares maiores estão associados a quantidades menores de ajuda, então a correlação será negativa. Usando um computador, a correlação pode ser calculada: -0.499.↩︎
Existem aplicações onde o Critério (1.3) pode ser mais útil, e há muitos outros critérios que podemos considerar. No entanto, este livro aplica apenas o critério de mínimos quadrados.↩︎
A tendência parece ser linear, os dados caem ao redor da linha sem valores atípicos óbvios, a variação é aproximadamente constante. Estas também não são observações de séries temporais. Regressão de mínimos quadrados pode ser aplicada a esses dados.↩︎
Se você precisar de ajuda para encontrar este local, desenhe uma linha reta a partir do valor x de 100 (ou próximo disso). Em seguida, desenhe uma linha horizontal em 20 (ou próximo). Essas linhas devem se cruzar na linha de mínimos quadrados.↩︎
Aplicando a Equação (1.5) com as estatísticas resumidas da Tabela 1.1 calcular a inclinação: \(b_1 = \frac{s_y}{s_x} R = \frac{5.46}{63.2}(-0.499) = -0.0431\)↩︎
www.cc.com/video-clips/l4nkoq↩︎
\(R^2 = (-0.97)^2 = 0.94\) ou 94% da variação é explicada pelo modelo linear.↩︎
Estes dados foram coletados no outono de 2009 e pode ser encontrado em openintro.org.↩︎
Forneceremos duas considerações. Cada um desses pontos teria uma alavancagem muito alta em qualquer linha de regressão de mínimos quadrados, e anos com tão alto desemprego podem não nos ajudar a entender o que aconteceria em outros anos em que o desemprego é apenas modestamente alto. Por outro lado, são casos excepcionais, e estaríamos descartando informações importantes se as excluirmos de uma análise final.↩︎
Examinamos a segunda linha correspondente à variável renda familiar. Vemos que a estimativa pontual da inclinação da linha é de -0,0431, o erro padrão dessa estimativa é de 0,0108 e a estatística do teste-\(t\) é de -3,98. O p-valor corresponde exatamente ao teste bilateral em que estamos interessados: 0.0002. O p-valor é tão pequeno que rejeitamos a hipótese nula e concluímos que a renda familiar e a ajuda financeira do Elmhurst College para ingressantes no ano de 2011 estão negativamente correlacionadas e o verdadeiro parâmetro do coeficiente angular é de fato menor que 0, assim como acreditamos Exemplo 1.12.↩︎