O GESPLA Toolbox
Recentemente desenvolvemos uma caixa de ferramentas em python para facilitar nossas atividades de pesquisa no grupo de pesquisa em Gestão e Planejamento de Recursos Hídricos (GESPLA). O propósito da caixa de ferramentas, que vamos chamar aqui de GESPLA Toolbox, é providenciar um conjunto de rotinas na forma de módulos de python. As rotinas disponíveis são operações unitárias que podem ser acopladas em qualquer código python. Assim, o objetivo do post é anunciar a ferramenta e descrever suas funcionalidades. Entendemos que o advento de ferramentas computacionais abertas, facilmente disponíveis por repositórios e operáveis em plataformas de computação de nuvem, como o Google Colab, são inevitáveis. Esperamos estar contribuindo para esse progresso, não (re)inventando a roda, mas participando desse movimento.
Por Iporã Possantti (possantti@gmail.com), Engenheiro Ambiental, Doutorando em Recursos Hídricos e Saneamento Ambiental (IPH/UFRGS)
Ah, antes de ler o post, saiba que é possível acompanhar o post executando exemplos no Google Colab no seguinte link:
https://colab.research.google.com/drive/1CtwL3KSqGCxJqCu0TSM5BtFrc4ay3N3w?usp=sharing
Uma caixa de ferramentas
Recentemente desenvolvemos uma caixa de ferramentas em python para facilitar nossas atividades de pesquisa no grupo de pesquisa em Gestão e Planejamento de Recursos Hídricos (GESPLA). O propósito da caixa de ferramentas, que vamos chamar aqui de GESPLA Toolbox, é providenciar um conjunto de rotinas na forma de módulos de Python. As rotinas disponíveis são operações unitárias que podem ser acopladas em qualquer código python. Os módulos disponíveis (até agora) são separados pelas seguintes classes de funcionalidades:
- Download de dados e metadados hidrometeorológicos da ANA;
- Importação de dados e metadados do disco para o código;
- Processamento de séries temporais;
- Análise de séries temporais;
- Visualização de séries temporais;
É bom ressaltar que não estamos inventando a roda aqui: existem diversas formas de executar as operações disponíveis, com outras ferramentas. Inclusive ocorreu recentemente o lançamento pelo grupo de pesquisa de Hidrologia de Grande Escala (HGE) de um complemento para o QGIS para baixar dados da ANA, chamado ANA Data Acquisition. Assim com a nossa caixa de ferramentas, o complemento também é de código aberto.
O diferencial dessas ferramentas consiste na reprodutibilidade e facilidade de distribuição, pois a estão codificadas de forma aberta (python) e disponível (sob licensa open source) em um repositório público de códigos chamado GitHub.
Link para acessar o repositório: https://github.com/gespla-iph-ufrgs/gespla.
Como antes mencionado, uma vantagem adicional do GESPLA Toolbox é que as rotinas disponíveis podem ser acoplados (literalmente inseridas) em outros códigos. Ou seja, se você, por exemplo, precisa obter um DataFrame da análise de frequências ou exportar um gráfico, a nossa ferramenta faz isso.
Dependências necessárias
Como qualquer biblioteca de “alto nível” (isto é, que executa tarefas específicas) o GESPLA Toolbox está apoiado sobre outras bibliotecas, ou dependências. Uma delas é a hydrobr, uma biblioteca de grande valia. Eventualmente você pode gostar mais dessa biblioteca que a nossa. Mas garanto que a nossa biblioteca é mais simples, pois é baseada apenas em funções, não em objetos (como é o caso da hydrobr). Programação orientada a objetos pode ser um exagero no caso de processamento de dados.

Onde o GESPLA Toolbox está na “pirâmide de bibliotecas” de python
Como mostra a figura acima, além do python 3, é preciso instalar as seguintes dependências:
numpypandasmatplotlibscipystatsmodelstdqmhydrobr
Todas as dependências (com exceção da hydrobr) são bibliotecas plenamente consolidadas no ecossistema python. Por isso, se você estiver no Google Colab, só é necessário instalar a hydrobr.
No Google Colab, uma boa forma de começar é criar um arquivo python (.py) e executar os comandos de importação das dependências. Depois disso, você precisa fazer upload dos módulos na plataforma.
# importar dependências básicas
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import scipy

# instalar a Hydrobr
!pip install hydrobr
Os módulos e funções
O segundo passo é carregar na mesma pasta os módulos do GESPLA Toolbox. Por enquanto são os seguintes arquivos:
download.py– para download de dados e metadados;load.py– para importação de dados e metadados;resample.py– para processamento de séries temporais;tsa.py– para análise de séries temporais;visuals.py– para visualização de séries temporais;
Mas o que são esses módulos? Cada módulo é um arquivo python (.py) com funções. Os módulos são independentes entre si, portanto você pode usar apenas o que for necessário. As funções internas de cada módulo, contudo, podem ter dependências locais de outras funções. Isso significa que copiar e colar um trecho do módulo em outro código pode resultar em problemas. Sempre use o módulo inteiro como uma nova dependência do seu projeto, importando as funções.
As funções (e seus relativos retornos e parâmetros) estão completamente documentados por docstrings. Uma docstring é um comentário com a função de documentação no cabeçalho da função. Você pode ler uma docstring de várias formas:
- Simplesmente leia ela no próprio código;
- Execute o comando
help()passando como argumento o nome da função. Exemplo:
# importa a função metadata_ana_flow do módulo download
from download import metadata_ana_flow
# convoque a docstring pelo comando help():
help(metadata_ana_flow)
3. ou imprima na tela o atributo .__doc__ . Exemplo:
# importa a função metadata_ana_flow do módulo download
from download import metadata_ana_flow
# impressão do atributo .__doc__:
print(metadata_ana_flow.__doc__)
No caso acima, a docstring da função metadata_ana_flow é seguinte:
"""
This function downloads metadata for all flow stations registered in the  Brazilian  National Agency of Water (ANA).
File is saved in .txt format
To the file name is attached the date of download in format: 'YYYY-MM-DD'
     Dependencies:
    * HydroBr as hb
    * Pandas as pd

:param folder: [optional] string of output directory (ex: 'C:/Datasets/Hydrology' )

:param suff: [optional] string suffix for file name

:return: string of file path (ex: 'C:/Datasets/Hydrology/metadata_ANA-flow_2020-10-19.txt' )
"""
Módulo download – baixando dados e metadados para arquivos txt
O método convencional de baixar dados hidrometeorológicos é simplesmente ir no Hidroweb, digitar o código da estação de monitoramento desejada e clicar no ícones de download.
O primeiro problema do método convencional é que você precisa saber previamente o código da estação de monitoramento. E isso não necessariamente é óbvio. O SNIRH disponibiliza um SIGWeb, é verdade. Mas melhor que isso é obter todos os metadados da Rede Nacional Hidrometeorológica em um arquivo txt e inspecionar o banco de metadados com seus próprios critérios, incluindo visualizar em ambiente SIG a distribuição espacial das estações.
O segundo problema é que os dados baixados do Hidroweb nunca estão alinhados em uma série temporal, mas em uma matriz de mês-ano por dias do mês. Como o número de dias em um mês varia, é preciso fazer muita ginástica em alguma planilha eletrônica para extrair do arquivo do Hidroweb uma série temporal.
Assim, o módulo download resolve todos esses problemas. Este módulo armazena funções para download de dados e metadados. Os arquivos são salvos no formato de texto (.txt, separado por ponto e vírgulas) em um diretório especificado no parâmetro folder= das funções. Se não for especificado, o diretório padrão é a pasta atual do arquivo python que está convocando a função. Todas as funções retornam a string do caminho do arquivo salvo.
As dependências gerais do módulo são:
pandastdqmhydrobr
Lista das funções atuais do módulo:
.metadata_ana_flow(folder)– baixa os metadados de todas as estações de vazão da ANA..metadata_ana_prec(folder)– baixa os metadados de todas as estações de precipitação da ANA..metadata_inmet(folder, opt)– baixa metadados de todas as estações climáticas do INMET, definidas por tipo..metadata_ana_telemetry(folder)– baixa metadados de todas as estações telemétricas da ANA..metadata_ana_rhn_inventory(folder)– baixa os metadados do inventário completo das estações da ANA..ana_flow(code, folder)– baixa dados de vazão de uma única estação de vazão de ANA..ana_stage (code, folder)– baixa os dados de cota de uma única estação de vazão de ANA..ana_prec(code, folder)– baixa os dados de precipitação de uma única estação de precipitação da ANA..inmet_daily(code, folder)– baixa dados climáticos diários de uma única estação climática do INMET. Veja docstring para variáveis..inmet_hourly(code, folder)– baixa dados climáticos por hora de uma única estação climática do INMET. Veja docstring para variáveis.
Módulo load – importar os dados para um DataFrame
Este módulo armazena funções para importar dados armazenados em arquivos criados pelo módulo download. A maior parte do download tem uma contrapartida em load.
Os dados nos arquivos são carregados em um objeto DataFrame. Esse objeto é o coração da biblioteca pandas e permite praticamente todas as manipulações possíveis com os dados. O DataFrame é o Santo Graal da análise de dados com python.
Dependências gerais:
pandas
Lista das funções atuais:
.ana_flow(file)– carrega em umDataFrameos dados de vazão de uma única estação de vazão de ANA..ana_stage(file)– carrega em umDataFrameos dados de cota de uma única estação de vazão de ANA..ana_prec(file)– carrega em umDataFrameos dados de precipitação de uma única estação de precipitação da ANA..inmet_daily(file)– carrega em umDataFrameos dados climáticos diários de uma única estação climática do INMET. Veja docstring para variáveis..inmet_hourly(file)– carrega em umDataFrameos dados climáticos horários de uma única estação climática do INMET. Veja docstring para variáveis..metadata_ana_flow(file)– carrega em umDataFrameos metadados das estações de vazão / cota da ANA..metadata_ana_prec(file)– carrega em umDataFrameos metadados das estações de precipitações da ANA..metadata_inmet(file)– carrega em umDataFrameos metadados das estações climáticas do INMET.
Módulo resample – reamostrando os dados em diferentes escalas de tempo
Este módulo armazena funções para reamostrar séries temporais, como de diário para mensal. Os dados de entrada são passados como um objeto DataFrame para que as funções os processem e retornem um novo objeto DataFrame contendo a nova série temporal. As variáveis agregadas retornadas são:
- Periods count – número de períodos agregados
- Count – número de registros válidos agregados
- Sum
- Mean
- Min
- Min
- Max
- Q25 – quantil 25
- Q50 – quantil 50 (mediana)
- Q75 – quantil 75
Dependências gerais:
pandasnumpy
Lista das funções atuais:
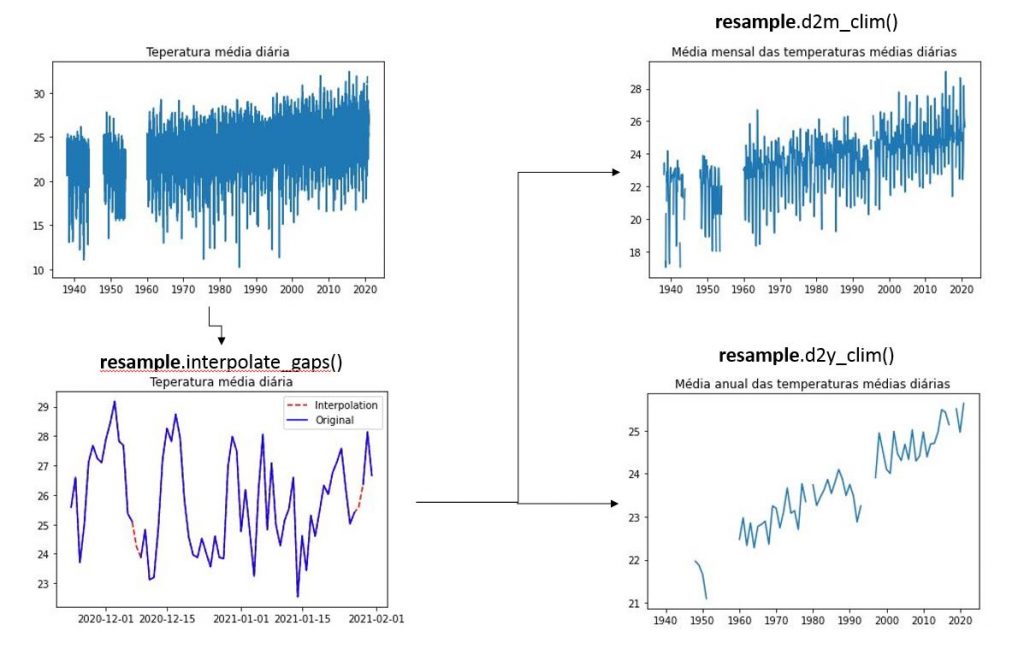
.d2m_prec(dataframe)– reamostrando as séries temporais de precipitação de diário para mensal..d2m_flow(dataframe)– reamostrando a série temporal do vazão de diário para mensal..d2m_stage(dataframe)– reamostrando as séries temporais do estágio de diário para mensal..d2m_clim(dataframe)– reamostrando as séries temporais das variáveis climáticas de diário para mensal..d2y_prec(dataframe)– reamostrando as séries de tempo de precipitação de diário para anual..d2y_flow(dataframe)– reamostrando a série temporal de vazão de diário para anual..d2y_stage(dataframe)– reamostrando as séries temporais do estágio de diário para anual..d2y_clim(dataframe)– reamostrando as séries temporais das variáveis climáticas de diário para anual..insert_gaps(dataframe)– insere registros nulos em intervalos de data ausentes da série temporal..interpolate_gaps(dataframe)– interpola intervalos definidos por tamanho de registros nulos em uma série temporal..clear_bad_months(dataframe)– remove da série temporal os meses que possuem registros nulos (falhas)..clear_bad_years(dataframe)– remove dos anos da série temporal que possuem registros nulos (falhas)..resampler(dataframe)– esta função é a função utilitária de reamostragem do módulo..group_by_month(dataframe)– esta função agrupa uma série temporal diária em 12 séries temporais para cada mês do ano. As 12 séries retornam em um objetodictionary.
Assim, o módulo permite uma análise estatística em múltiplas escalas temporais, como mostra a figura abaixo. A figura abaixo mostra claramente que a temperatura média diária está aumentando nos últimos 50 anos nessa Estação do INMET (83423 – Goiânia).
Módulo tsa – análise de séries temporais
Este módulo armazena funções para análise de séries temporais (tsa = time series analysis), como análise de frequência e decomposição ETS. Os dados de entrada são passados como um objeto DataFrame para que as funções os processem e, em seguida, retornem um novo objeto DataFrame contendo as novas séries / objetos temporais.
Dependências gerais:
pandasnumpystatsmodels
Lista das funções atuais:
.frequency(dataframe)– Obtenha umDataFramecom percentis, probabilidade de excedência, frequência e probabilidade empírica de uma série temporal..sma(dataframe)– Obtenha a série de tempo da média móvel simples de uma janela de tempo definida..ewma(dataframe)– Obtenha a média móvel de ponderação exponencial de uma janela de tempo definida..ets_decomposition(dataframe)– função executa a decomposição ETS (Error, Trend, Seasonality) sobre uma série temporal.
A função .ets_decomposition()é particularmente interessante, pois decompõe a série nas componentes estocásticas, sazonais e tendenciais, como ilustra a figura abaixo:

Decomposição ETS com a função tsa.ets_decomposition()
Módulo visuals – visualização de dados
Este módulo ainda está sendo desenvolvido e objetiva armazenar funções para visualização de dados. É comum gastar bastante tempo bolando os gráficos para análise, o que pode ser reduzido com um conjunto de funções pré-definidas. As funções serão programadas para exportar uma figura em .png com resolução de 300 dpi para um diretório especificado pelo parâmetro folder=.
Dependências gerais:
pandasnumpymatplotlib
Temos já uma função operativa, que exporta um painel de análise referente a uma única série temporal, função pannel_singlets().
Além do DataFrame da série, é preciso fornecer para a função outros objetos produzidos por funções dos módulos anteriores, tais como o DataFrame da função tsa.frequency() e da função resample.group_by_month().
O resultado são painéis tais como esses:

Painel das vazões – Estação ANA 20200000 (em Goiás)

Painel da precipitação – Estação INMET 83423 (Goiânia)

Painel da Temperatura – Estação INMET 83423 (Goiânia)
Conclusão
Com isso, concluímos que o advento de ferramentas computacionais abertas, facilmente disponíveis por repositórios e operáveis em plataformas de computação de nuvem, como o Google Colab, são inevitáveis. Esperamos estar contribuindo para esse progresso, não (re)inventando a roda, mas participando desse movimento.
Atualizações das ferramentas serão notificadas pelo blog.
Bom uso!
